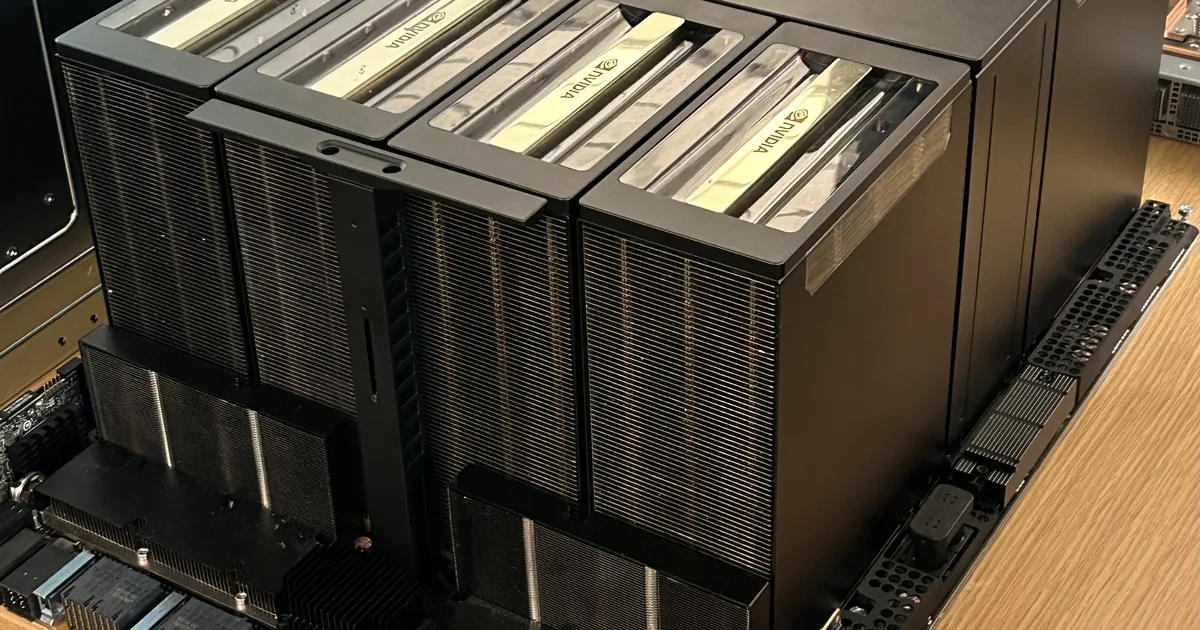
A Nvidia revelou como usa agentes de IA para cuidar dos próprios supercomputadores, as chamadas “fábricas de IA” onde modelos são treinados. Em um artigo técnico publicado em 4 de novembro, a empresa descreve o AI Factory Operations Agent, um sistema que recebe perguntas dos engenheiros em linguagem natural e distribui a investigação entre agentes especializados em hardware, rede, agendamento de tarefas e registros. A Nvidia também abriu o código da estrutura que coordena esses agentes, ainda em versão experimental.
O problema que os agentes tentam resolver
Quem mantém um cluster de GPUs funcionando é o engenheiro de confiabilidade, conhecido pela sigla SRE. Segundo os autores do texto, Kavya G Y e Rohan Adwankar, esses profissionais costumam abrir vários painéis diferentes para descobrir por que o desempenho de um treinamento caiu. A falha pode estar numa placa com erro de memória, num cabo de rede, numa fila de tarefas mal distribuída ou no próprio software, e cada camada tem sua ferramenta de monitoramento.
A proposta é juntar essas pistas numa conversa só. O engenheiro descreve o problema num chat, e o sistema decide quais agentes devem investigar, cruza os sinais das diferentes camadas e apresenta uma recomendação. Cada ação fica registrada para auditoria, e o profissional pode alternar entre investigações sem perder o histórico.
Quem é quem entre os agentes de IA
O sistema reúne seis agentes com funções separadas. O de recuperação de tarefas detecta quando um treinamento falha ou perde rendimento e procura a causa no agendador, na aplicação, no hardware e na rede. O agente de hardware investiga defeitos em componentes específicos, como erros de memória, falhas de SSD e superaquecimento, enquanto o de observabilidade consulta o histórico de métricas e registros e monta gráficos na hora.
Completam o time um agente de pesquisa, que consulta manuais e guias de referência da Nvidia e aceita documentos internos enviados pela equipe, um agente que acompanha o estado do Kubernetes, o sistema que distribui as tarefas pelas máquinas, e outro que conversa com o Base Command Manager, software de gestão de clusters da empresa. A Nvidia diz que o sistema roda hoje nas operações internas dos seus supercomputadores DGX SuperPOD, em clusters com os modelos DGX H100, B200 e GB300.
Primeiro investigar, depois agir
O ponto mais enfatizado pela Nvidia é a segurança. Os agentes de IA trabalham, por padrão, apenas com leitura: podem consultar pods e configurações, mas não podem ler segredos, criar ou alterar nada no cluster. Comandos de terminal rodam numa área isolada criada para cada sessão pelo OpenShell, ferramenta da empresa para controlar agentes, e essa área não recebe credenciais do Kubernetes nem mexe nas cargas de produção.
A empresa resume a lógica numa das cinco lições listadas no texto: uma investigação precisa conquista a confiança do engenheiro antes de qualquer automação. As outras lições falam em dar fronteiras claras a cada agente, porque “responsabilidades sobrepostas geram ruído, não sinal”, cruzar dados de várias camadas, descrever bem cada ferramenta para que o sistema escolha a certa e mostrar o raciocínio, com as consultas feitas e as evidências, antes de o profissional tomar uma decisão.
A recomendação para quem quiser adotar o modelo é rodar os agentes num ambiente separado do cluster de produção, para não consumir as GPUs de treinamento. O sistema pode funcionar inteiramente dentro da empresa, com modelos abertos Nemotron, da própria Nvidia, o que atende organizações preocupadas em não enviar dados para fora.
O que ainda falta saber
O texto da Nvidia não traz números de resultado. Não há dados sobre tempo economizado, quantidade de incidentes resolvidos ou taxa de acerto do diagnóstico, e o vídeo de demonstração mostra uma falha inserida de propósito num cluster interno, não um incidente real. A empresa afirma que continua medindo a precisão das análises de causa e o grau de concordância dos engenheiros com as conclusões dos agentes, mas não divulgou esses valores.
A estrutura de orquestração está disponível como software livre experimental no GitHub, com o aviso de que interfaces e requisitos podem mudar entre versões. Os agentes desenvolvidos pela Nvidia para operar clusters, porém, são oferecidos a clientes mediante pedido ao gerente de conta. Não há informação de preço nem de disponibilidade específica para o Brasil.
Um retrato de para onde vão os agentes
O caso ilustra uma tendência que vai além da Nvidia: em vez de um único assistente genérico, empresas montam equipes de agentes com papéis definidos e regras rígidas sobre o que cada um pode fazer. É a mesma ideia defendida pelo Google DeepMind, para quem o salto econômico da IA depende de agentes que saibam trabalhar em equipe. Para quem está começando no assunto, o MUNDOTOPIA tem um guia sobre o que é inteligência artificial.
Há também um motivo financeiro. Cada hora de GPU parada custa caro, e as big techs vêm sendo cobradas por investidores pelos gastos bilionários com infraestrutura de IA. Ferramentas que encontram falhas mais rápido tendem a ganhar espaço, mas a Nvidia ainda precisa mostrar, com números, quanto o modelo realmente economiza.
Fontes e referências
- NVIDIA Technical Blog — How NVIDIA Uses AI Agents to Streamline AI Factory Operations
- GitHub (NVIDIA) — AI-Factory-Operations-Agent
- NVIDIA — DGX SuperPOD